过去十年,算力的增长主要靠两件事支持:制程进步,和堆卡。但当我们真正把大模型往国产算力上搬的时候,最先撞上的反而是一个更朴素的问题:对于特定的国产硬件,软件层如何在硬件上达到极致的性能?
推理框架和底层算子依赖资深工程师一层层手工调优,底层换一种芯片,整套软件往往要自下而上推倒重调。我们的思路,是把“发现瓶颈、提出改法、真机验证”这个原本由工程师完成的循环,交给自进化工程智能(Self-Evolving Engineering-AI,SEE)7×24 小时跑起来。这篇文章将介绍我们的自进化工程智能在软件层算力提升上的突破。
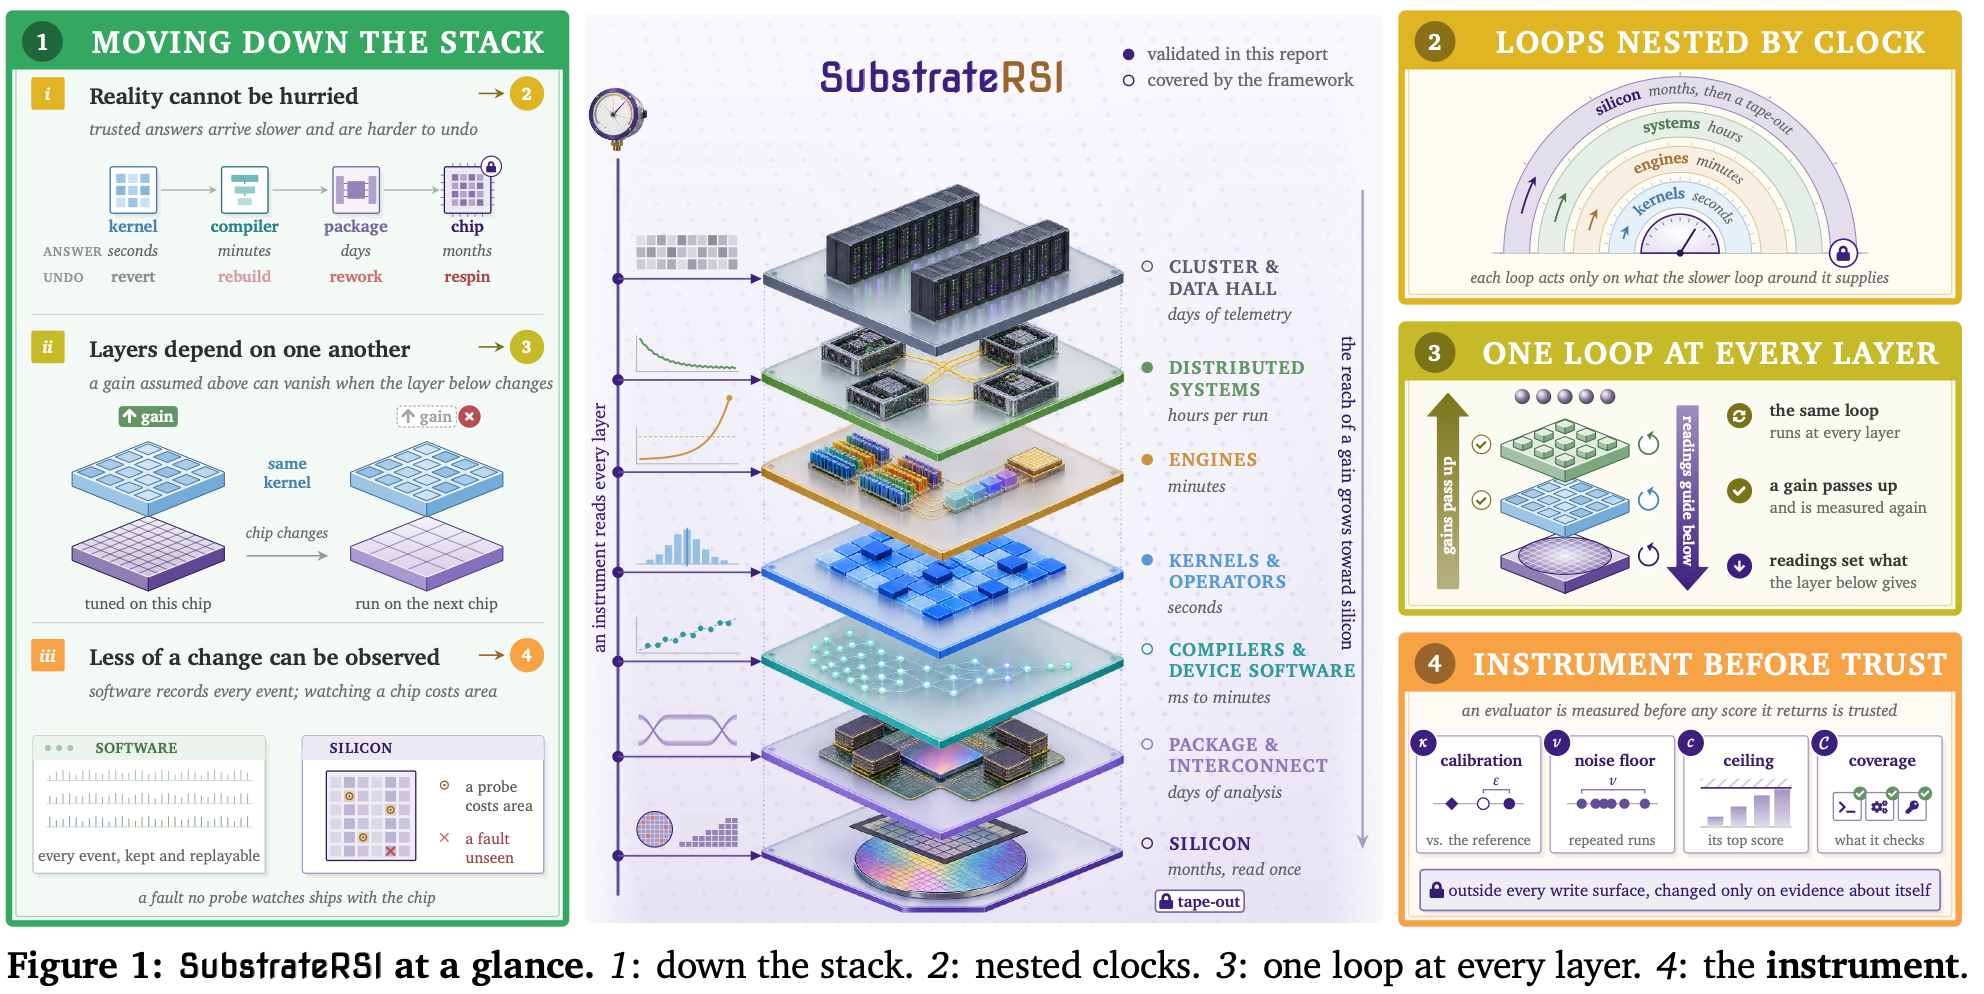
先拆开算力系统的底座看。最上面是集群调度,往下依次是分布式系统、推理引擎、算子与编译器,再往下是封装与互连,最底层是硅片。这个分层结构有一个规律:改动越靠下,受益面越宽,例如一个算子改快了,所有调用它的模型都跟着快;但越往下,判断一次改动的好坏也越难,算子几秒钟就能实测一轮,芯片要等版图冻结数月后才第一次被测量。所以我们给每一层先定好三件事:改写权限、用什么方式验证、一次可信的验证要花多久,再一层层往下进化。
一、标准考题:自进化系统在三套 Benchmark 上的成绩
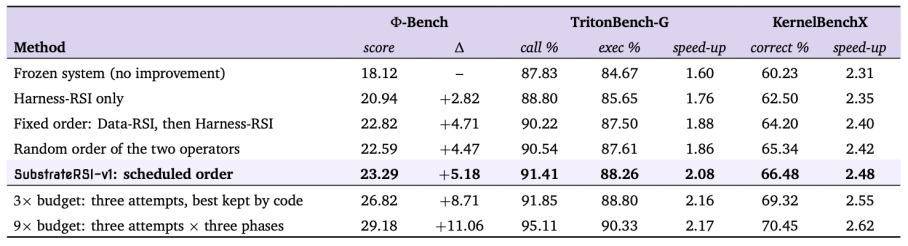
第一组证据来自行业公开的标准考题。我们在三套各有侧重的测试集上检验了同一套 MetaRSI-v1 闭环:覆盖真实训推仓库级端到端优化的 Φ-Bench、采用 GitHub 真实算子考察接口调用与加速的 TritonBench-G,以及涵盖 15 类算子生成任务、专考正确率与硬件效率的 KernelBenchX。
测试结果显示,同一套自进化闭环将正确 kernel 的生成占比从 60% 推高至 70%,生产算子的加权加速比显著提升;在 9 倍搜索预算设置下,Φ-Bench 得分提升 11.06 ,KernelBenchX 正确率达到 70.45%,加速比达 2.62。
二、真实生产:MiniMax H3 推理速度达官方实现的 450%
比刷榜更有说服力的,是第二组真实生产负载上的端到端验证。自进化内核以 SGLang 官方标准部署为基线逐轮实测,在这条已经快过官方原版的基线上继续往上走,最终把 MiniMax H3 的推理速度推到了官方实现的 450%。
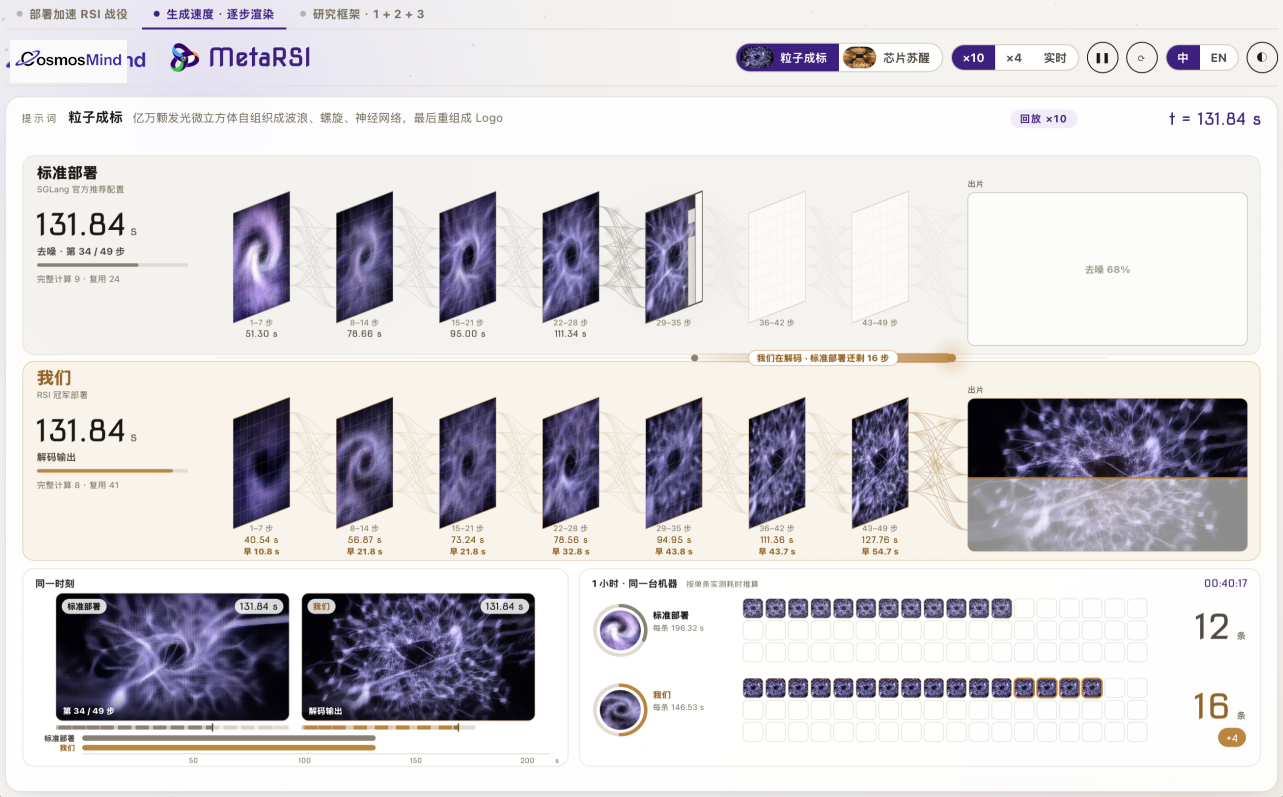
我们支持国内大模型团队将业务迁移到国产算力时,遇到的最棘手问题往往不是“跑不起来”,而是直接迁移后明显的性能折损。以 330 亿参数的音视频联合扩散模型 MiniMax H3 为例,当服务部署到昇腾 910B 上、跑的是 768P、24fps、5 秒视频的生成任务时,许多原本按英伟达显卡调出来的参数会水土不服:比如残差复用的阈值原封不动搬到昇腾上,性能不仅没快,反而直接劣化了 71%;又如条件注入合并算子的启用条件,在原代码里被写死在了英伟达卡上,换卡后根本无法触发。
面对庞大的参数与算子组合空间,人类工程师通常只能凭经验挑少数几个点试探,大量潜在最优配置在方案阶段根本无暇覆盖。我们的自进化内核则把整个 H3 部署当成搜索空间,自动批量提出候选方案、部署上卡、实测速度、客观判定,一轮接一轮往前推进,整个调优过程在官网公开直播,每一轮改了哪行代码、快了多少毫秒,外部开发者都可以随时回看。
把阈值在本地重新标定之后,残差复用反而成了收益最大的一项。五十步采样里,相邻步的中间结果高度相似,原本要重复计算的部分可以直接复用,叠上高阶外推还能多跳几步,单这一项就把耗时相对SGLang基线压低了 12.9%。
除了揪出上述残差复用阈值的跨卡劣化陷阱,相比 SGLang 最优方案部署,自进化闭环还在昇腾算子融合上拿下了两项关键收益:将归一化替换为华为原生的合并算子,单这一项就削减了 7.1% 的耗时,把单条请求的底层指令下发次数从约 8000 次直接压到了 1 次;同时解锁并重调条件注入(AdaLN)融合,耗时再降 4.1%。
最终在五套不同视频生成 Benchmark 数据集的输入 Prompt 实测中,逐条配对测试没有一条变慢;生成画质经 VBench 2.0 评测与 SGLang 基线持平,并通过了人眼盲测终裁。这样的自进化优化,正在让国产算力持续增强商业竞争力。
三、成果开源:基于 PyPTO 的四个开源库
为了让自进化产出的算子真正服务于端到端业务,我们选择在华为昇腾开源的新一代原生高性能编程框架 PyPTO 上深耕。可以把 PyPTO 理解为昇腾生态里承上启下的一层:向上对接大模型与推理服务,向下直接操控昇腾硬件的指令与存储层级,让开发者能用更高层的方式编写高性能算子,而不必逐行手写底层硬件代码。
在持续产出代码的过程中,闭环内部还同步自适应训练了一个 35B 参数的模型:它先从昇腾 910 的硬件指令与存储层级学起,再把 PyPTO 基于 Tile 的多级 IR、编程模型与 CodeGen 机制内化进自身的生成逻辑。每一轮提案的成败都会沉淀为模型对框架更深的理解,越往后跑,高质量算子的命中率越高。
顺着“前沿模型重算子 → 推理服务栈碎算子 → 完整端到端推理链”的脉络,这套闭环基于 PyPTO 产出了四个开源库(均已在 GitHub CosmosMind-ai 开源):
两个专用 Kernel:其一是 PyPTO-FlashDSA,针对 DeepSeek 从 V3.2 引入、V4.1 定型的稀疏注意力机制 DSA,做出了昇腾 910 上第一个完整跑通的 V4.1 实现;其二是 PyPTO-FlashKDA,覆盖 Kimi Linear 的核心递归算子 KDA,补上了昇腾 PyPTO 生态里第一个完整的 KDA 实现,在 GLM decode 形状上快 4.16 倍。
通用算子库 PyPTO-Ops:由闭环在推理服务栈的接缝处自主发掘融合改写机会,公开 27 个算子,铺满 vLLM 类推理服务的关键路径,涵盖归一化、激活与 GLU、量化、MoE 路由、KV cache、采样与 loss;其中按行动态 INT8 量化快 3.81 倍。
端到端推理服务 PyPTO-Lib:在 Qwen 大模型、8 张昇腾 910C 的集群配置下,基于 PyPTO-Lib 的端到端推理服务使逐 token 延迟下降 4.43%、吞吐提升 2.8%,且生成结果与基线逐比特严格一致。目前,该库已被 PyPTO 官方团队正式合入主干。
四个库的开源仓库地址如下:
PyPTO-FlashDSA:https://github.com/CosmosMind-ai/pypto-flashdsa
PyPTO-FlashKDA:https://github.com/CosmosMind-ai/pypto-flashkda
PyPTO-Ops:https://github.com/CosmosMind-ai/pypto-ops
PyPTO-Lib:https://github.com/CosmosMind-ai/qwen3-14b-910c-decode-opt
我们在软件侧的努力不会停止。随着新的模型和新的国产硬件不断涌现,我们会继续把自进化工程智能用在更多场景上,让每一代国产硬件的性能都能被软件层挖掘到极致。