当软件层的优化被做到极致,自进化工程智能(Self-Evolving Engineering-AI,SEE)便下沉到Design time。我们选择的第一个方向,是硅光芯片:用光信号代替电信号,在芯片之间传输数据。
在大规模 AI 算力集群里,硅光互连是突破带宽与功耗墙的必经之路,这一点行业早有共识,而真正的瓶颈是怎么做出“上产线良率依然稳得住”的设计。
一、硅光设计难在哪:人工极难兼顾的问题
长期以来,硅光芯片设计有三处难点。
设计与制造脱节。纳米级的刻蚀或线宽偏差,就足以让器件性能大幅走样。仿真里的好设计进了 Fab 常常失灵,行业只能靠多轮流片试错、在芯片上铺预补偿阵列碰运气,试错一轮就是好几个月。
光、电、热强耦合。调制器、电驱动、接收端与热控往往分属不同工程团队,各模块为了保险各自留足余量,拼在一起后整条链路离全局最优总差一截。
人才稀缺。能同时驾驭光、电、热与半导体制造工艺的资深工程师屈指可数,这种设计能力很难规模化复制。
这三道多变量耦合题,恰好是自进化工程智能擅长的战场。硅光有成熟可信的物理仿真器,每一个设计都能被客观检验,这正是 RSI 闭环成立的前提。我们把 Fab 的工艺扰动提前写进检验标准,把良率前置到设计第一天;把光、电、热放进同一个物理仿真闭环里同步寻优;再让多智能体 7×24 小时自主迭代,把稀缺专家的经验沉淀成可复用的软件能力。
二、直播里最值得看的两个瞬间
整个设计过程在官网 7×24 小时公开直播,累计已完成 1469 轮自主迭代,每一轮决策轨迹都可以回看。翻看直播记录,有两个细节最具代表性。
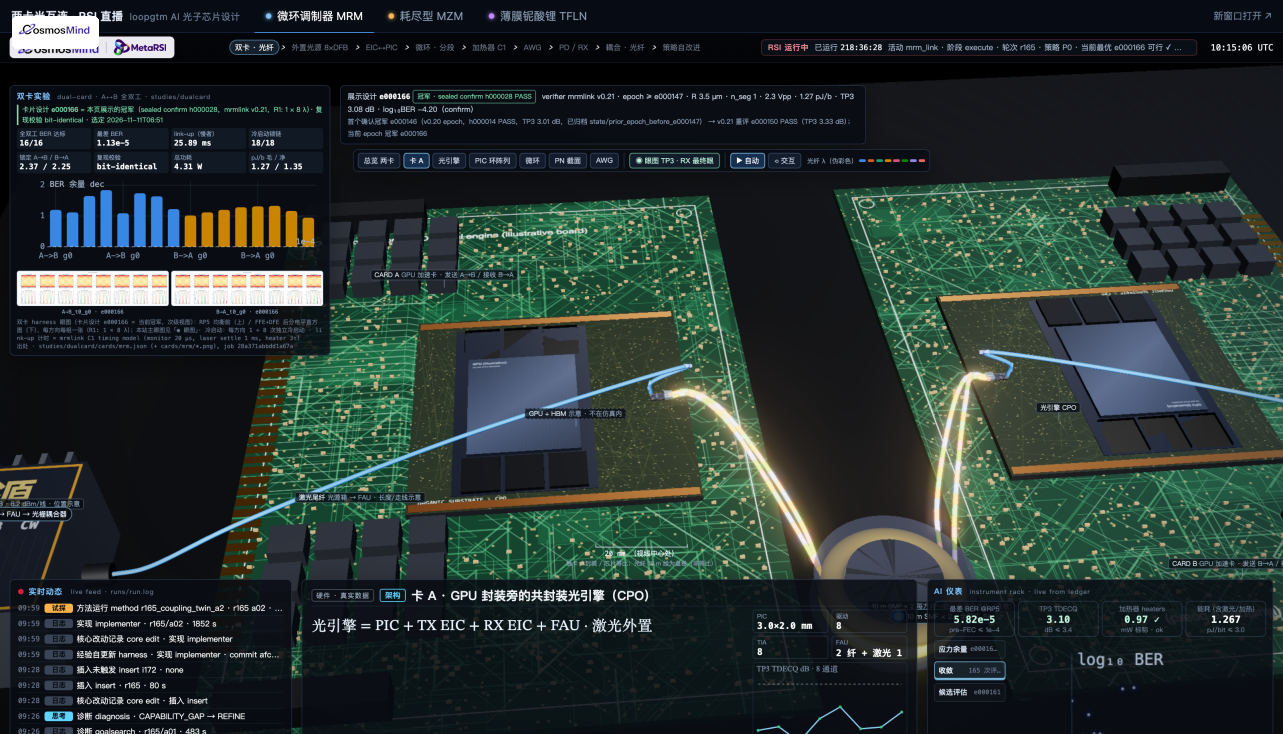
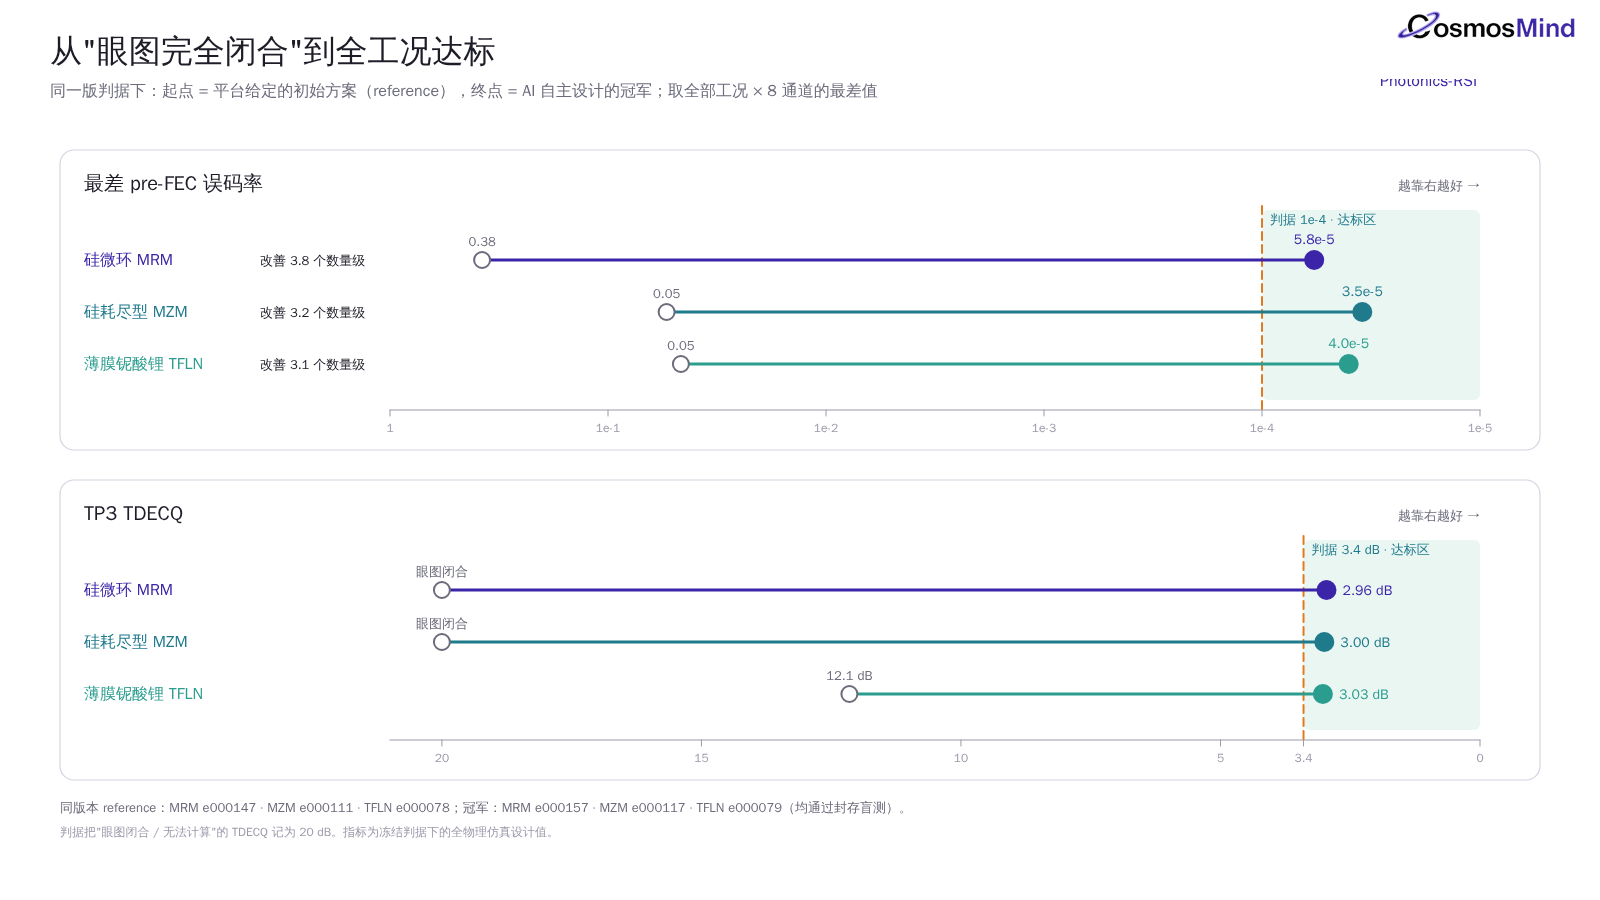
第一是从零到达标。每条链路的起点都是眼图完全闭合、根本无法通信的初始状态,SEE 自主把它推演至全工况达标,误码率改善超过三个数量级,新任务上线最快 49 分钟就能交出首个全达标方案。
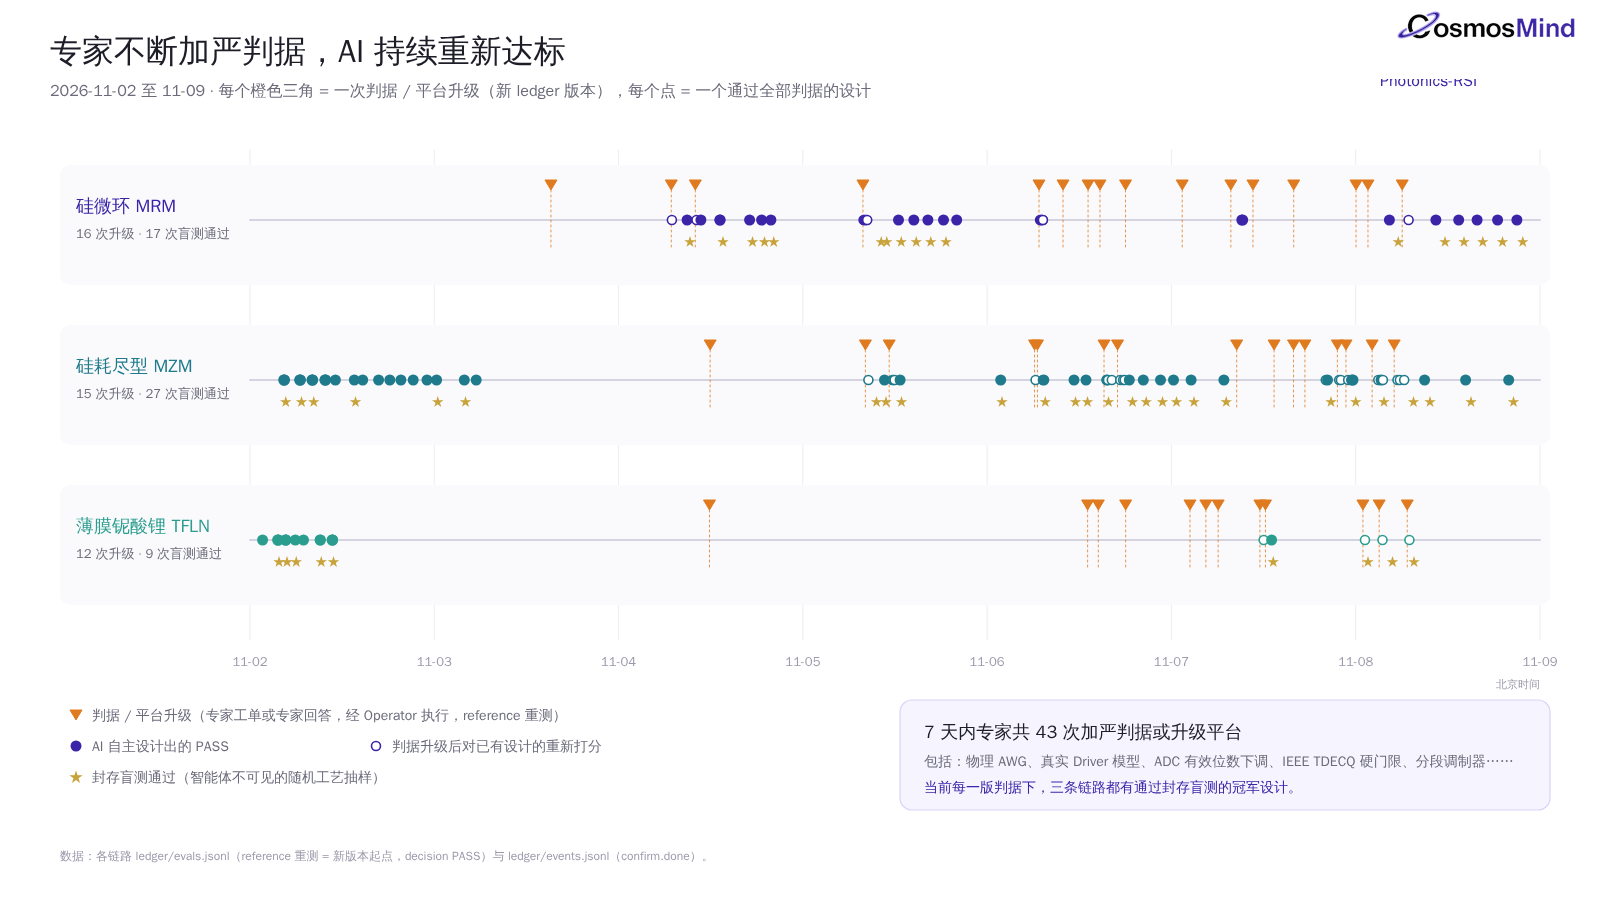
第二是高效的 Human-in-the-Loop。7 天里,人类专家先后 43 次手动加严验收标准,每次门槛抬高后 SEE 都能重新追平,目前三条路线在最新标准下全部达标。
三、器件级:攻克 0° 垂直耦合,工艺容差领先顶刊一个数量级
先看最底层的器件关。光栅耦合器相当于光信号进出芯片的大门,其中 0° 垂直出射光栅耦合器是硅光领域公认的难题,它的出射周期恰好落在二阶布拉格反射条件上,衬底反射光与出射光同轴叠加,传统参数扫描方法在这里基本失效。我们与北京大学光子传输与通信全国重点实验室联合攻关,让自进化闭环在两次刻蚀、最小特征不低于 80 nm 的可量产约束下跑出了两条路线:高效率路线实现了 −0.66 dB 的亚分贝级耦合损耗;宽带鲁棒路线的带宽比 2026 年《Optica》报道的同类设计宽 40%,线宽制造偏差下的波长漂移缩小了一个数量级。此前前沿文献需要在芯片上铺 15 组预补偿阵列来挑选可用器件,这套设计连 1 组都不用铺。同一套闭环还给出了分偏振二维光栅,仅靠单个 14 µm 的器件就能把两个偏振态干净分离,端口隔离度超过 20 dB,偏振相关损耗近乎为零。27 个工艺工况下,带内最低耦合效率相对标称只下降 0.63 dB;±8 nm 线宽偏差下,峰值波长漂移不超过 2 nm。
更值得注意的,是系统搜索出来的非直觉拓扑。在光栅的“超原胞”设计上,人类专家受经验习惯影响,通常只会顺着“尺寸渐变”的思路找解,而自进化系统自主给出了一套“三种原胞拓扑共存”的方案。为了验证含金量,我们把对照组拉到当前最高水平:由 R&D 领域人类专家直接搭配主流 Coding Agents,且不限 token 预算,同台竞技。实测对比显示,MetaRSI 驱动的系统依然找到了更优器件结构,在效果、效率与成本三项指标上依次占优,核心性能始终排在第一位。
四、走到真实产业:首个面向量产、工艺鲁棒的纯 RSI 流片
设计图画得再巧,终究要进 Fab 过产线这一关。为了让流片不再像“开盲盒”,我们把良率保障拆成五道关卡贯穿始终。投片前连过三关:版图阶段直接叠加上刻蚀、线宽、套刻、膜厚波动与可量产规则硬约束;每个候选方案都在全部工艺角下做完整物理仿真,只认最差值、不看标称值;拿到冠军的方案还要再过一轮智能体看不见的隐藏测试,用随机工艺组合检验。流片后再接两关:残留的物理偏差交给只依赖片上实测物理量的片上闭环控制器吸收;最终的晶圆量测数据再回流系统,持续校准扰动模型本身。
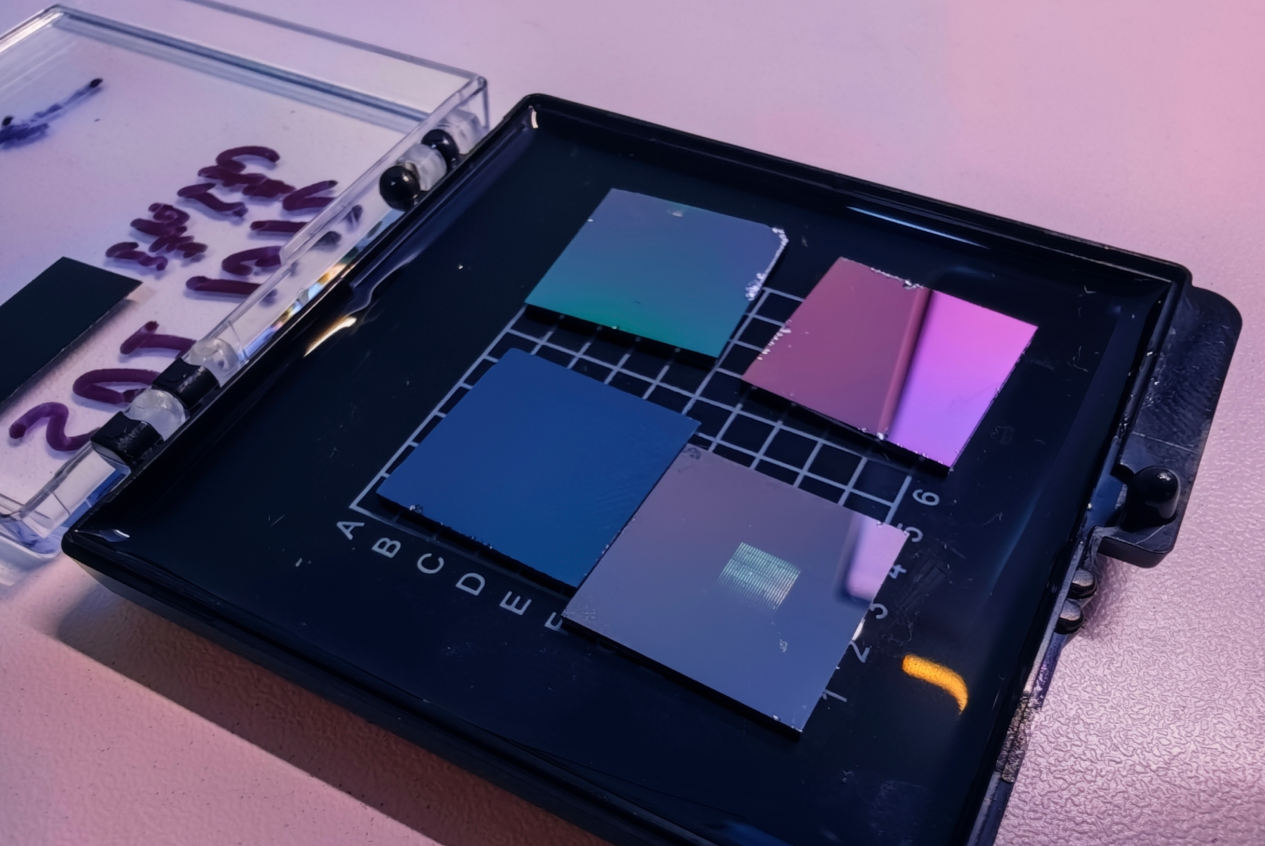
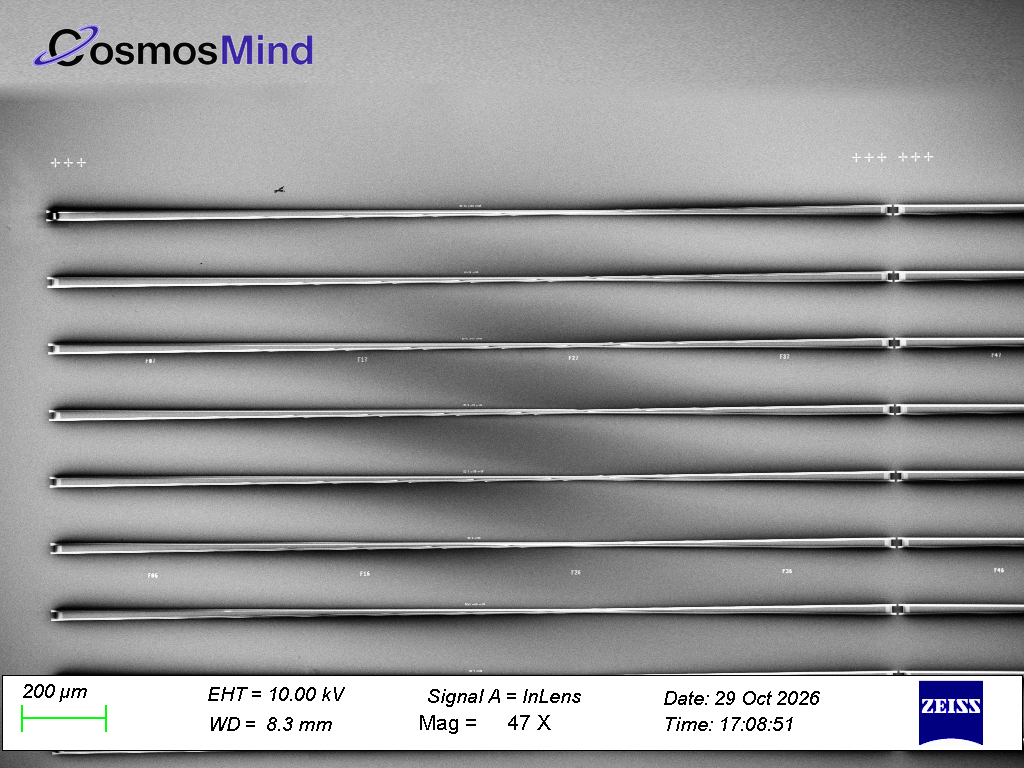
如今,第一版硅光测试芯片已经从 Fab 回片。系统从 31 张 SEM 照片中自动识别出每一条刻蚀边缘,量化真实加工误差,在仿真器里重建出芯片的真实三维形状并预测性能,再反过来修正下一版版图。电镜实测数据显示,芯片单特征随机线宽离散标准差 σ 不超过 5 nm,而设计阶段是按 σ = 10 nm 的严苛口径评估的,相当于在真实产线上留出了约 2 倍的安全余量。
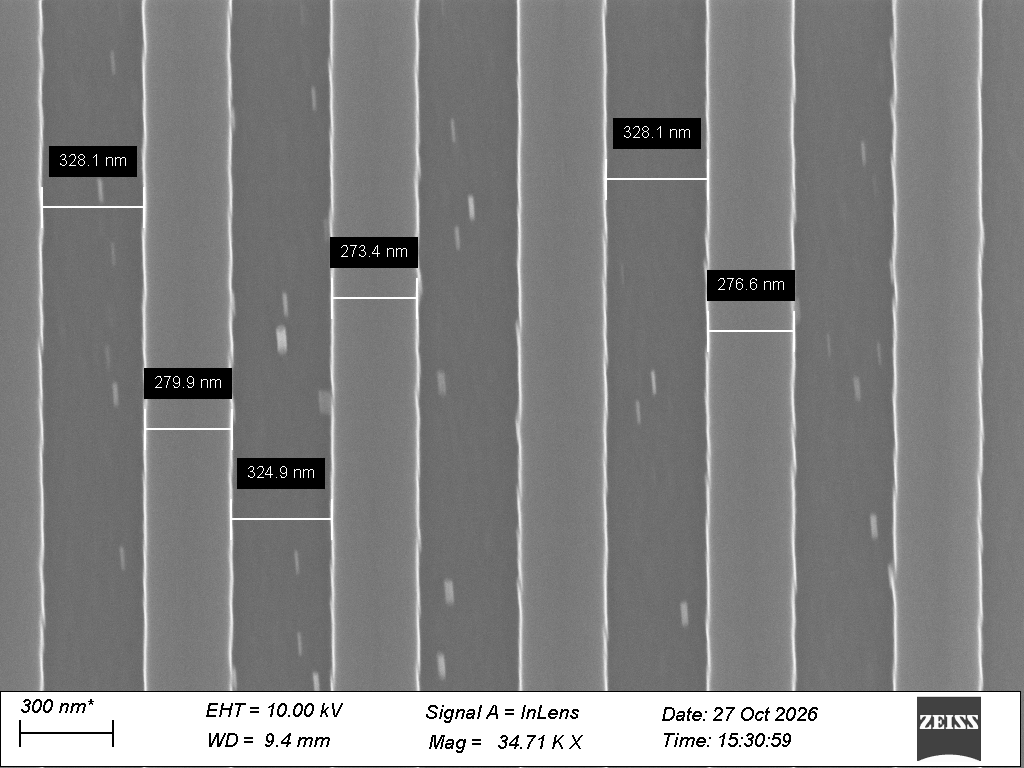
“设计、流片、量测、再设计”的实物飞轮由此正式转了起来,这也是业内首个面向工业级量产且具备工艺鲁棒性的纯 RSI 自进化流片。同一过程中,研发引擎 Ester 基于真实工业流片与电镜量测数据,自适应训练了一个 35B 模型,专门学习刻蚀、线宽与套刻偏差在真实工艺中的累积规律,让仿真环境越来越贴近真实产线。
五、系统级:一周打通 1.6T 光互连三大主流路线
单点器件站稳之后,闭环顺势向上接管了复杂的系统级互连。我们正式发布的 Ester-Photonics 自主光电设计平台不绑定任何单一架构与材料,让多智能体在全物理仿真环境里并行跑,架构选择完全由目标与约束决定,不到一周时间,就独立完成了全部三条主流路线的 8×200G、单向 1.6 Tb/s 光互连链路“电口到电口”联合设计,且全工况达标。
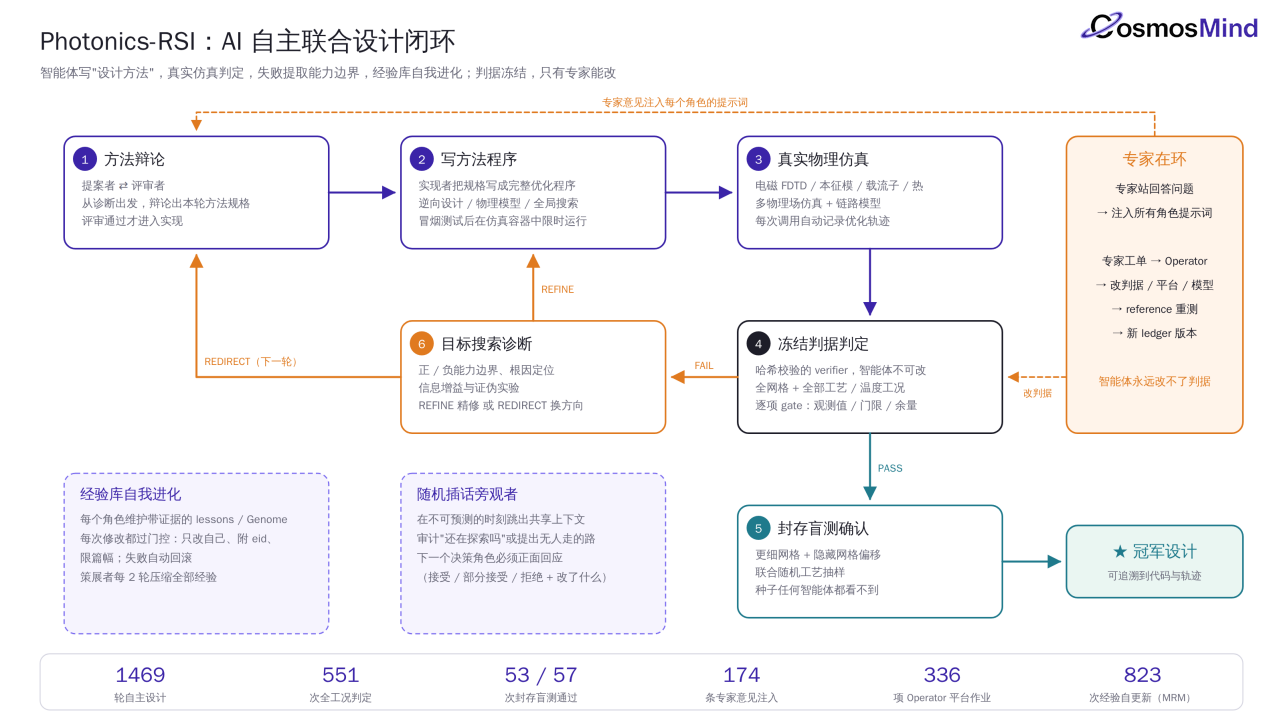
在链路层级,光、电、热仿真同框运行,电域的 Driver、TIA、SerDes 与光域器件一起被列为可调设计变量,每一道加工刻槽都在设计之初代入了工艺良率约束。三条路线上,SEE 各自长出了一项传统模块化流程很难触及的跨界设计:
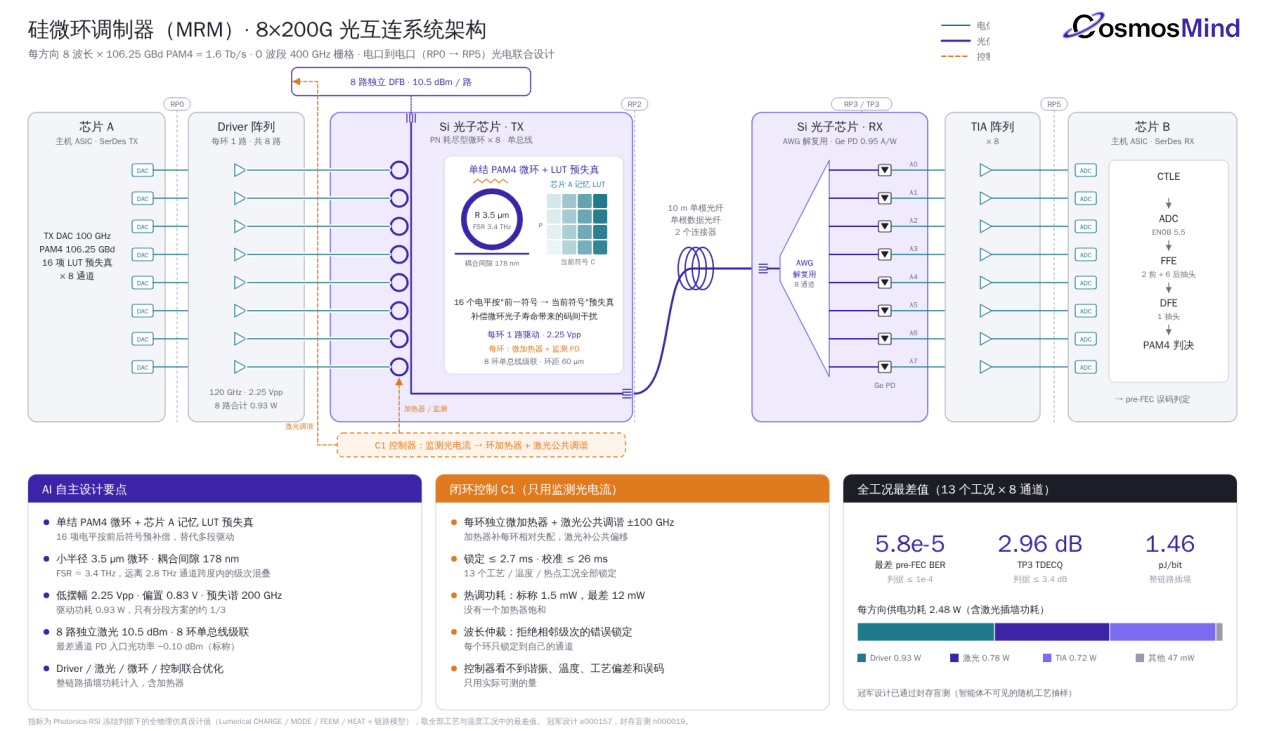
- 硅微环(MRM)路线:针对微环响应慢导致的前后符号串扰,让发射端电芯片提前通过 LUT 做预失真补偿,查找表共 16 项,8 个半径 3.5 µm 的微环共用一根总线,自由光谱范围约 3.4 THz;8 路驱动总功耗仅 0.93 W;温度漂移由闭环热锁定在 2.7 ms 内追回,热调功耗最高不超过 12 mW。
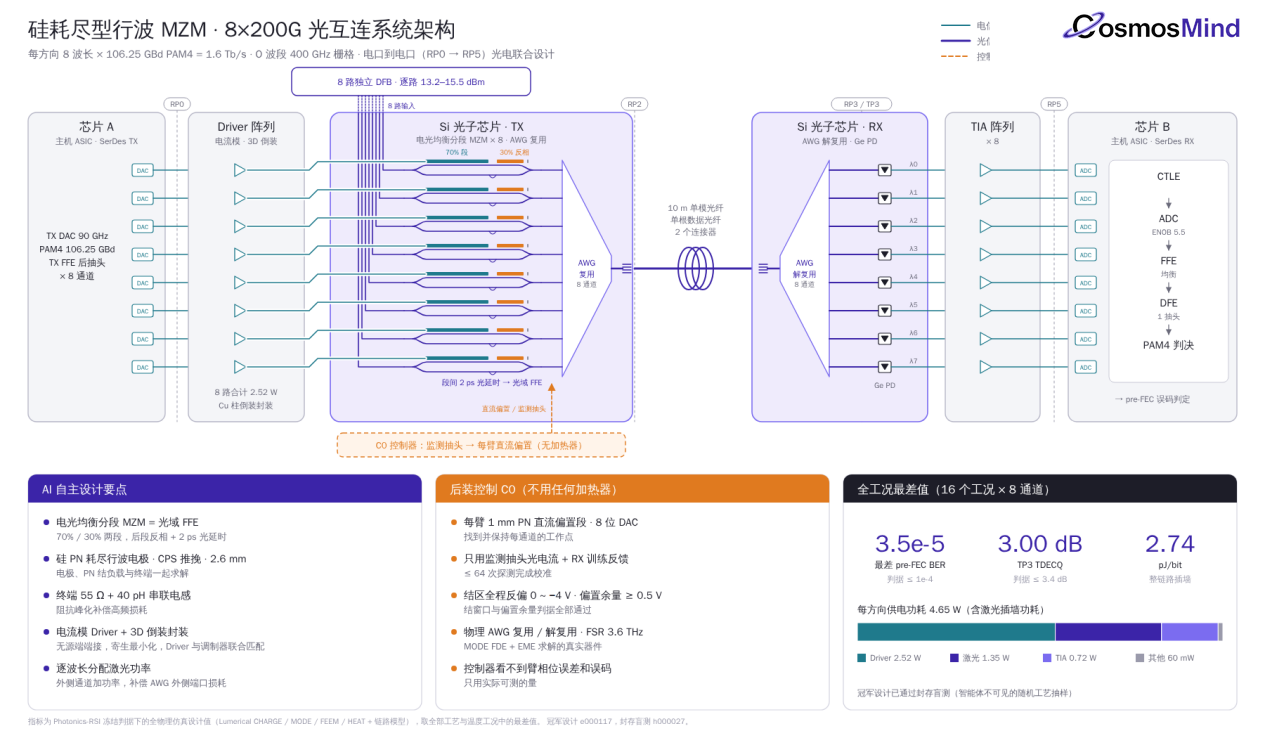
- 硅耗尽型 MZM 路线:把原本由复杂电路承担的信号均衡 FFE 搬到光路上,将调制器拆成按 70%/30% 反相的两段,中间插入一段 2 ps 的光延时,直接在光域完成均衡。
- 薄膜铌酸锂(TFLN)路线:采用 2.6 Vpp 驱动,8 路合计功耗 1.6 W,省去高功耗加热器,偏置漂移全部由直流电极实时跟踪,AWG 加热器经深槽隔热后最差工况合计 10.5 mW,电极场强距击穿留了 6 倍余量;在 12 个工况 × 8 通道测试中实现 100% 偏置控制成功。
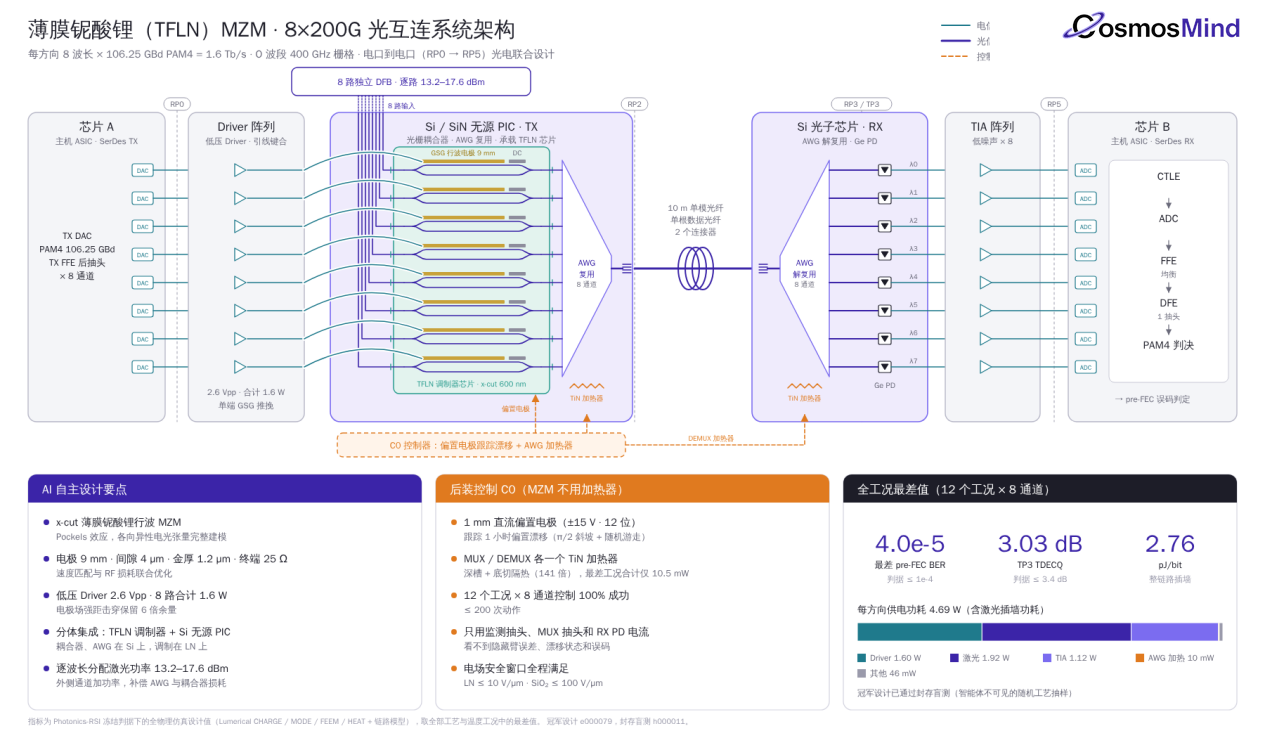
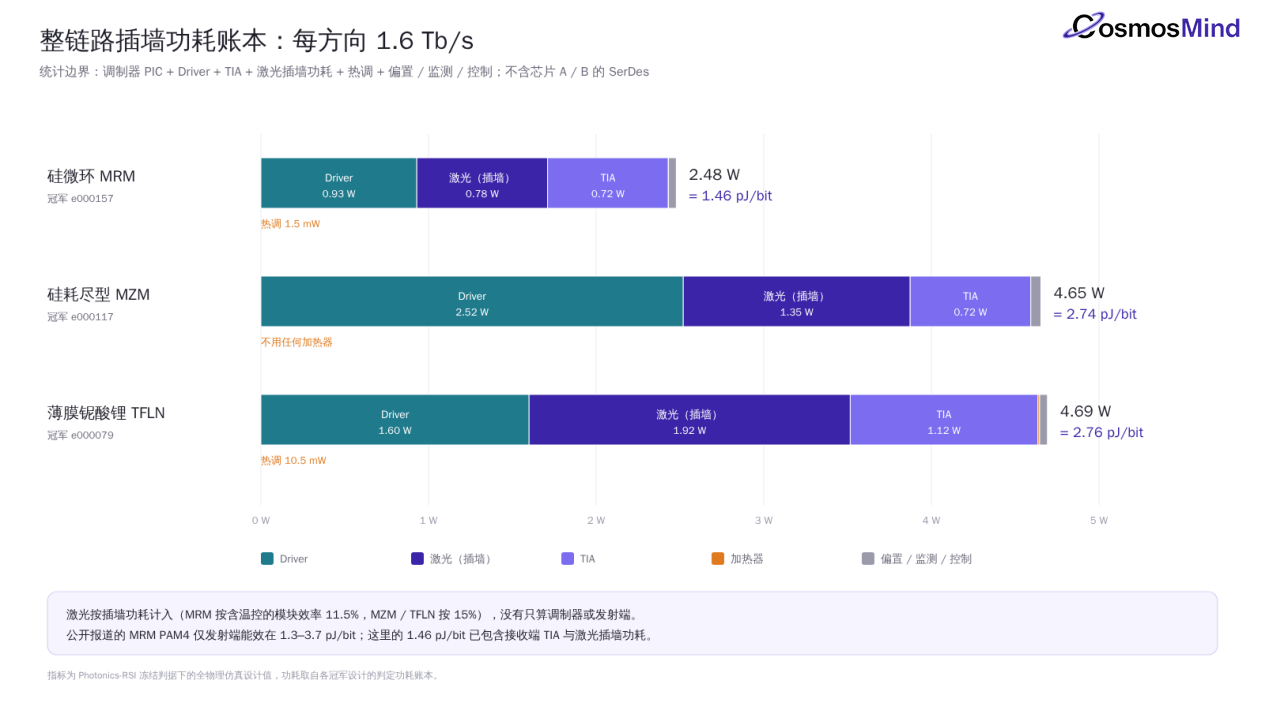
更关键的是验收标准够严。行业论文里常见的 1.3–3.7 pJ/bit 能效指标,往往只统计发射端局部功耗,而我们采用从发射芯片电口一直算到接收芯片电口的整链路插墙功耗,且在全工况、全通道中只取最差值。在这套口径下,三条 1.6T 链路最差的 pre-FEC 误码率分别为 5.8e-5、3.5e-5、4.0e-5,全部低于 1e-4;信号质量指标 TDECQ 落在 2.96–3.03 dB,而公开报道的硅光 MZM 在一半速率(53 到 56 GBd)下 TDECQ 还要 2.6 到 3.8 dB,均满足 IEEE 标准门限,整条链路能耗最低压至 1.46 pJ/bit。
随着首版芯片回片与系统级方案跑通,产业界已经给出实质响应,目前多家 Fab 主动联系,探讨联合设计与工艺模型合作。对我们来说,第一版芯片回片不是终点,而是一个可以被检验的起点:硬件的突破会在自进化工程智能的加持下不断发生。